发布时间:2026-09-18 13:01:01作者:xx
在语音转写、实时字幕等to b与to c场景中,讯飞听见的低延迟高准确率体验,核心依托其成熟的语音流处理机制与实时通信技术体系,打破了传统整段语音处理的延迟瓶颈。
讯飞听见采用端侧优先的分层预处理逻辑,不对完整语音文件做统一处理,而是对输入语音流进行分片切割与前置过滤:端侧首先完成回声消除、远场降噪与端点检测,快速区分有效语音段与空白静音,过滤掉冗余的静音片段后仅将有效数据上传,大幅降低后续推理与通信环节的带宽压力。针对会议、户外采访、直播等不同场景,系统还能自适应调整采样率与降噪参数,对混响、背景噪音等干扰做前置剥离,为后续识别环节提供干净的输入源。
不同于传统端侧识别准确率不足、纯云端推理延迟高的痛点,讯飞听见采用端云协同的流式推理机制:端侧完成语音分片的预处理后,逐片将语音特征增量发送至云端,云端识别模型采用增量编码器架构,仅对新输入的语音分片做特征计算,同时缓存前文的语义与声学特征,通过上下文关联修正同音异义词、多音字的识别结果,实现“说出即转写出”的效果,正常网络下端到端延迟可控制在300ms以内,满足实时字幕、同传转写等低延迟需求。
针对户外会议、移动场景下的弱网问题,讯飞听见的实时通信层做了多层容错优化:采用动态抖动缓冲机制,根据实时网络抖动情况调整缓冲区间,网络稳定时缩小缓冲降低延迟,网络波动时扩大缓冲减少包乱序;同时结合轻量前向纠错技术,对语音分片做冗余编码,少量数据包丢失时无需重传即可通过冗余信息恢复,避免了重传带来的延迟飙升,断网重连后也支持断点续处理,不会丢失断网阶段的语音内容,保障复杂网络下转写体验的稳定性。这套技术组合平衡了准确率与延迟需求,为多场景实时语音处理提供了成熟的落地路径,全文约652字。
免责声明:以上内容源自网络,版权归原作者所有,如有侵犯您的原创版权请告知,我们将尽快删除相关内容。
如何成为抖音外卖骑手
抖音冰墩墩特效视频怎么拍摄
淘宝怎么购买冬奥会吉祥物冰墩墩
支付宝早起打卡失败怎么回事
2022春运火车票提前多久预售
支付宝2022年年有余活动怎么玩
支付宝隔离政策在哪里查
支付宝嘉图借书怎样还书
微信星星特效怎么触发
拼多多答题领iPhone答案是什么
prx8比率拉伸工具在哪里
Visual Studio Code如何打开或关闭小地图
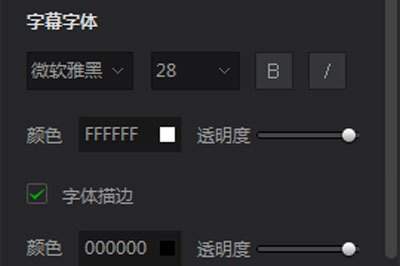
OPlayer手机版如何设置字幕加粗
怎么在Gamma写跨团队通知提示词时加入使用场景
学习通官网入口网址是什么
AO3镜像官方网站是什么
premiere如何制作音乐节奏卡点视频
爱剪辑怎么制作视频倒带效果
文心一言写影评提示词如何设置输出格式
iPhone输入法怎么切换
决胜台球是款台球竞技比赛闯关游戏,游戏中玩家可以体验到非常真实的台球玩法,有着大量的关卡可以去解锁闯关,可以在商城中进行购买各种风格的球杆,不断的提高实力,达到更高的段位。游戏特色1.游戏中的奖励多样,轻松解锁不同的球杆2.简单在游戏中进行规划撞击,完成台球比赛3.关卡匹配,玩法不同,游戏自由选择游戏亮点1.简单游戏操作玩法,在游戏中轻松提升技巧2.学习更多的台球知识,轻松在游戏中封神3.精致游戏
3.2
火爆三国手游是很好玩的三国策略战争手游,在游戏中会有很多的武将可以让玩家来进行获取,游戏中的武将都是三国中耳熟能详的人物,玩家在游戏中可以指挥自己的角色在游戏中开始精彩的战斗。游戏玩法超多的武将选择,更结合武将养成的玩法,喜欢这款游戏的不要错过,游戏中玩家可以不断解锁强力武将,中后期随着等级的提升也能打出爆发的伤害,非常节省玩家的时间,并且还搭配了各种的技能,感受全新的乐趣体验。游戏介绍火爆三国是
3.1
射爆香肠人是款画面视角非常独特的休闲闯关游戏,在一开始玩家需要慢慢的熟悉玩法教程,就可以快速的上手了,有点类似于塔防的玩法机制,选择摆放一个个的角色,来阻止各种的香肠人通过。游戏特色1.超级丰富的闯关内容等待你的加入,通过各个关卡中的挑战来体验丰富的游戏乐趣!2.在一次次的闯关挑战当中来积累更多的经验,收集更多的道具,以此提升自己的闯关能力!3.紧张刺激的射击对战过程,每个关卡里面出现的香肠人战斗
4.2
我踢得贼准是款非常趣味的足球射门闯关小游戏。游戏中玩家将操控中角色进行调整好角度和方向来进行一次次的射门,角色离球门的距离是会越来越远的,需要准确的调整好位置与角度。游戏特色1.自由组建自己的游戏团队,在游戏中轻松战斗2.真实好玩的游戏挑战过程,轻松进行游戏冒险3.夺得冠军,轻松简单提升自己的踢球实力游戏亮点1.不同的踢球规则,在游戏中尽情发挥自己的实力2.全新游戏比赛规则,感受绿茵足球的战斗乐趣
4.9
极速逃亡3是一款十分有趣的逃脱类游戏,在游戏中有很多的武器可以让玩家来进行选择,游戏中的武器都是十分地好用的,玩家可以在游戏中通过自己的闯关在游戏中获得更多的武器来帮助自己进行闯关。游戏特色1、游戏的玩法十分新颖,玩家可以轻松尝试全新的逃脱玩法。2、海量关卡自由挑战,每次闯关都是一次全新的体验。3、完成游游戏的逃脱任务,获取丰厚的游戏奖励。游戏魅力1、玩家要快速找到敌人防御最薄弱的环节,利用这样的
3.5